Domain falschgeldstift.de kaufen?
Wir ziehen mit dem Projekt
falschgeldstift.de um.
Sind Sie am Kauf der Domain
falschgeldstift.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain falschgeldstift.de kaufen?
Wo wird das k-means Clustering verwendet?
Das k-means Clustering wird in verschiedenen Bereichen der Datenanalyse und des maschinellen Lernens eingesetzt. Es wird häufig zur Gruppierung von Datenpunkten verwendet, um Muster oder Cluster zu identifizieren. Beispiele für Anwendungen sind die Segmentierung von Kunden in Marketinganalysen, die Klassifizierung von Bildern oder die Analyse von Genexpressionsdaten in der Bioinformatik. **
Wie können Clustering-Algorithmen zur Strukturierung von großen Datenmengen eingesetzt werden? Welche Vorteile bietet das Clustering für die Analyse von Datensätzen?
Clustering-Algorithmen können große Datenmengen in Gruppen mit ähnlichen Merkmalen unterteilen, um Muster und Strukturen zu identifizieren. Durch das Clustering können komplexe Daten vereinfacht und interpretiert werden, um Einblicke und Erkenntnisse zu gewinnen. Dies ermöglicht eine effiziente Analyse von Datensätzen und die Identifizierung von Trends, Mustern und Ausreißern. **


Ähnliche Suchbegriffe für Clustering
Top-Angebote
Produkte zum Begriff Clustering:
-
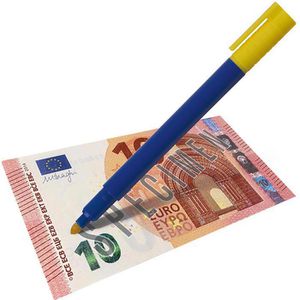
Genie Geldscheinprüfer Euro Quicktester, Geldscheinprüfstift, für BanknotenMerkmale: Ausführung: mobil, Stift Währung: Euro und andere Währungen weitere Produktinformationen: Prüftechnologie: Stift zur chemischen Analyse der Papiereigenschaften Prüfsignal: optisch sonstiges: färbt sich der Strich grau oder braun, ist der Geldschein vermutlich falsch Das Gerät prüft auch die neuen 100 und 200 Euro-Banknoten.0,98 €*Versand: 4,15 €Sichere Weiterleitung zum Anbieter
-
Wie lassen sich Daten mithilfe von Clustering-Algorithmen effizient in Gruppen einteilen? Welche Anwendungsfälle gibt es für Clustering in der Datenanalyse?
Clustering-Algorithmen gruppieren Datenpunkte basierend auf Ähnlichkeiten in Cluster. Dies geschieht durch die Berechnung von Distanzen zwischen den Datenpunkten. Anwendungsfälle für Clustering in der Datenanalyse sind z.B. Kunden-Segmentierung, Anomalieerkennung und Mustererkennung. **
-
Wie funktioniert ein Geldscheinprüfer und welche Merkmale werden zur Fälschungserkennung überprüft?
Ein Geldscheinprüfer überprüft die Echtheit von Banknoten durch verschiedene Merkmale wie Wasserzeichen, Sicherheitsfaden und Hologramme. Durch optische Sensoren und UV-Licht werden diese Merkmale auf Fälschungen überprüft. Bei Abweichungen von den echten Merkmalen wird der Geldschein als gefälscht erkannt und abgelehnt. **
-
Wie kann Clustering dazu beitragen, Muster und Strukturen in großen Datensätzen zu identifizieren? Was sind die Hauptanwendungen von Clustering-Algorithmen in der Datenanalyse?
Clustering gruppiert ähnliche Datenpunkte zusammen, um Muster und Strukturen in großen Datensätzen zu identifizieren. Durch die Identifizierung von natürlichen Gruppierungen können Trends und Zusammenhänge in den Daten aufgedeckt werden. Die Hauptanwendungen von Clustering-Algorithmen in der Datenanalyse sind Segmentierung von Kunden, Mustererkennung in Bildern und Texten, sowie Anomalieerkennung in Sicherheitsdaten. **
-
Wie kann das Clustering-Verfahren dazu beitragen, relevante Muster in großen Datenmengen zu identifizieren? Was sind die Anwendungsmöglichkeiten von Clustering in verschiedenen Branchen?
Das Clustering-Verfahren gruppiert ähnliche Datenpunkte zusammen, um relevante Muster zu identifizieren. Es kann helfen, Trends, Kundenpräferenzen oder Anomalien in großen Datenmengen zu erkennen. Anwendungen von Clustering finden sich in der Marktforschung, Medizin, Finanzwesen und im Bereich der Bildverarbeitung. **

Was sind die verschiedenen Methoden für das Clustering von Daten?
Die verschiedenen Methoden für das Clustering von Daten sind k-means, hierarchisches Clustering und DBSCAN. K-means gruppiert Datenpunkte basierend auf deren Ähnlichkeit in k vordefinierte Cluster. Hierarchisches Clustering erstellt eine Baumstruktur von Clustern, während DBSCAN Cluster basierend auf der Dichte der Datenpunkte bildet. **
Was sind die wichtigsten Techniken für das Clustering von Daten?
Die wichtigsten Techniken für das Clustering von Daten sind k-means, hierarchisches Clustering und DBSCAN. K-means gruppiert Datenpunkte basierend auf deren Ähnlichkeit in k vordefinierte Cluster. Hierarchisches Clustering erstellt eine Baumstruktur der Datenpunkte basierend auf deren Ähnlichkeit, während DBSCAN Cluster anhand der Dichte der Datenpunkte bildet. **
Top-Angebote
Produkte zum Begriff Clustering:
-
GO Europe, Geldzähler, Geldscheinprüfstift (Geldscheinprüfer)Der Geldscheinprüfstift von GO Europe ist ein handliches und tragbares Werkzeug, das einen effektiven Schutz vor Falschgeld bietet. Er eignet sich zur Prüfung von Euro, US-Dollar und britischen Pfund und ist somit vielseitig einsetzbar. Die Funktionsweise des Stifts basiert auf einer speziellen Tinte, die das verwendete Papier der Banknoten erkennt. Bei echtem Geld verblasst der Strich des Stifts zu einer kaum erkennbaren gelblichen Farbe, während er bei Falschgeld deutlich dunkel bleibt. Dies ermöglicht eine schnelle und unkomplizierte Überprüfung der Echtheit von Banknoten, was besonders in Zeiten zunehmender Geldfälschungen von Bedeutung ist. Der Stift ist ideal für den Einsatz in Geschäften, bei Veranstaltungen oder überall dort, wo Bargeld verwendet wird. Mit diesem praktischen Hilfsmittel können Sie sicherstellen, dass Sie nur mit echtem Geld arbeiten. - Prüft Euro, US-Dollar und britische Pfund - Einfache Anwendung durch Sichtprüfung - Schnelle Erkennung von Falschgeld - Handlich und tragbar für den täglichen Einsatz.32,24 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wo wird das k-means Clustering verwendet?
Das k-means Clustering wird in verschiedenen Bereichen der Datenanalyse und des maschinellen Lernens eingesetzt. Es wird häufig zur Gruppierung von Datenpunkten verwendet, um Muster oder Cluster zu identifizieren. Beispiele für Anwendungen sind die Segmentierung von Kunden in Marketinganalysen, die Klassifizierung von Bildern oder die Analyse von Genexpressionsdaten in der Bioinformatik. **
-
Wie können Clustering-Algorithmen zur Strukturierung von großen Datenmengen eingesetzt werden? Welche Vorteile bietet das Clustering für die Analyse von Datensätzen?
Clustering-Algorithmen können große Datenmengen in Gruppen mit ähnlichen Merkmalen unterteilen, um Muster und Strukturen zu identifizieren. Durch das Clustering können komplexe Daten vereinfacht und interpretiert werden, um Einblicke und Erkenntnisse zu gewinnen. Dies ermöglicht eine effiziente Analyse von Datensätzen und die Identifizierung von Trends, Mustern und Ausreißern. **
-
Wie lassen sich Daten mithilfe von Clustering-Algorithmen effizient in Gruppen einteilen? Welche Anwendungsfälle gibt es für Clustering in der Datenanalyse?
Clustering-Algorithmen gruppieren Datenpunkte basierend auf Ähnlichkeiten in Cluster. Dies geschieht durch die Berechnung von Distanzen zwischen den Datenpunkten. Anwendungsfälle für Clustering in der Datenanalyse sind z.B. Kunden-Segmentierung, Anomalieerkennung und Mustererkennung. **
-
Wie funktioniert ein Geldscheinprüfer und welche Merkmale werden zur Fälschungserkennung überprüft?
Ein Geldscheinprüfer überprüft die Echtheit von Banknoten durch verschiedene Merkmale wie Wasserzeichen, Sicherheitsfaden und Hologramme. Durch optische Sensoren und UV-Licht werden diese Merkmale auf Fälschungen überprüft. Bei Abweichungen von den echten Merkmalen wird der Geldschein als gefälscht erkannt und abgelehnt. **
Ähnliche Suchbegriffe für Clustering
-
Genie Geldscheinprüfer Euro Quicktester, Geldscheinprüfstift, für BanknotenMerkmale: Ausführung: mobil, Stift Währung: Euro und andere Währungen weitere Produktinformationen: Prüftechnologie: Stift zur chemischen Analyse der Papiereigenschaften Prüfsignal: optisch sonstiges: färbt sich der Strich grau oder braun, ist der Geldschein vermutlich falsch Das Gerät prüft auch die neuen 100 und 200 Euro-Banknoten.0,98 €*Versand: 4,15 €Sichere Weiterleitung zum Anbieter
-
Lancom VPN High Availability Clustering L Option (61658)Produktbeschreibung: LANCOM VPN High Availability Clustering L Option - Lizenz - 1 Lizenz, Produkttyp: Lizenz, Kategorie: Netzwerkanwendungen - Clustering / Hochverfügbarkeitssoftware, Anzahl Lizenzen: 1 Lizenz340,39 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann Clustering dazu beitragen, Muster und Strukturen in großen Datensätzen zu identifizieren? Was sind die Hauptanwendungen von Clustering-Algorithmen in der Datenanalyse?
Clustering gruppiert ähnliche Datenpunkte zusammen, um Muster und Strukturen in großen Datensätzen zu identifizieren. Durch die Identifizierung von natürlichen Gruppierungen können Trends und Zusammenhänge in den Daten aufgedeckt werden. Die Hauptanwendungen von Clustering-Algorithmen in der Datenanalyse sind Segmentierung von Kunden, Mustererkennung in Bildern und Texten, sowie Anomalieerkennung in Sicherheitsdaten. **
-
Wie kann das Clustering-Verfahren dazu beitragen, relevante Muster in großen Datenmengen zu identifizieren? Was sind die Anwendungsmöglichkeiten von Clustering in verschiedenen Branchen?
Das Clustering-Verfahren gruppiert ähnliche Datenpunkte zusammen, um relevante Muster zu identifizieren. Es kann helfen, Trends, Kundenpräferenzen oder Anomalien in großen Datenmengen zu erkennen. Anwendungen von Clustering finden sich in der Marktforschung, Medizin, Finanzwesen und im Bereich der Bildverarbeitung. **
-
Was sind die verschiedenen Methoden für das Clustering von Daten?
Die verschiedenen Methoden für das Clustering von Daten sind k-means, hierarchisches Clustering und DBSCAN. K-means gruppiert Datenpunkte basierend auf deren Ähnlichkeit in k vordefinierte Cluster. Hierarchisches Clustering erstellt eine Baumstruktur von Clustern, während DBSCAN Cluster basierend auf der Dichte der Datenpunkte bildet. **
-
Was sind die wichtigsten Techniken für das Clustering von Daten?
Die wichtigsten Techniken für das Clustering von Daten sind k-means, hierarchisches Clustering und DBSCAN. K-means gruppiert Datenpunkte basierend auf deren Ähnlichkeit in k vordefinierte Cluster. Hierarchisches Clustering erstellt eine Baumstruktur der Datenpunkte basierend auf deren Ähnlichkeit, während DBSCAN Cluster anhand der Dichte der Datenpunkte bildet. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.